日本服务器跑AI训练与动漫译制:带宽、版权、算力三笔成本账怎么算
做短剧和动漫二创出海的团队,最近常遇到一个两难:素材要拿来做AI字幕、配音、画面修复,模型和训练集动辄几十上百GB,放在日本机房下载快、离东北亚受众近;但素材本身涉及版权,训练、译制、分发三个环节的合规边界又不一样。真正要算的不是「哪台机器便宜」,而是带宽费、存储费、算力费和版权风险成本这四笔账怎么摊平。
一、先算带宽账:模型下载速度和素材回传,哪个更烧钱
AI训练素材的流转有两个方向:一是从公开模型库拉取权重(如Llama、Qwen系列的开源权重,单个模型常见几GB到上百GB),二是把客户的原始动漫、短剧素材回传到服务器做预处理。前者是突发大流量,后者是持续中等流量。日本机房到国内的线路质量差异很大,普通国际带宽在晚高峰会出现明显掉速,走BGP智能路由优化的线路通常更稳定。
按量估算:一部25分钟、1080p的动漫单集,原始素材约2~5GB;一季12集就是30~60GB。若每月处理20部短剧加若干动漫,素材吞吐量在1~3TB量级,再叠加模型权重的反复拉取,月流量很容易冲到10TB以上。这时候「G口带宽+大流量套餐」的物理机比按流量计费的云主机更可控,因为后者在突发下载时账单不可预测。
选购时要对比的参数清单:带宽是独享还是共享、流量是包月还是按量、回国线路是否优化、是否支持多IP。独享资源不超售的机型在批量下载模型时速度曲线更平,不会因为邻居跑满而卡在几百KB。
二、再算算力与存储账:训练、推理、渲染不是一台机器能全包的
很多团队把「AI训练」和「动漫译制」混在一起谈,其实负载完全不同。模型微调吃显存和GPU,通常需要专业卡;而字幕打轴、语音合成、画面超分、视频转码这些译制环节,更吃CPU多核和大容量NVMe存储。用一台纯CPU机器硬扛训练不现实,但用GPU机器做转码又浪费。合理的做法是分层:训练和推理放在有GPU的节点或按需租用云GPU,译制流水线和素材库放在日本物理服务器上。
存储量级上,动漫和短剧素材是典型的「大文件、冷热分层」。热数据(正在处理的集数)放NVMe,冷数据(成片和原始母带)放大容量HDD。按每月20部短剧、每部50GB估算,一年原始素材接近12TB,加上模型权重和中间文件,16TB级别的盘位是起步量级。这也是为什么带多块大容量硬盘的物理机在日本机房仍有市场——对象存储按量计费长期跑下来并不便宜。
合规上要提醒一句:日本版权法对「私的使用」有例外,但把受版权保护的动漫、影视素材用于模型训练、二次译制并商业分发,通常需要权利方授权。实操中建议做三件事:素材来源留痕、训练数据与分发内容分离管理、对明显侵权的整片搬运做规避。服务器放在日本不等于版权风险消失,只是管辖与取证环境不同。
三、落地怎么配:从轻量试水到批量流水线
小团队起步阶段,可以先用一台大带宽物理机做素材中转、字幕流水线和模型下载缓存,训练按需租GPU,避免一次性投入。等译制量稳定到每月几十部,再考虑把推理服务常驻化。
判断标准可以简化为三条:素材月吞吐量是否超过5TB(超过则优先G口大带宽)、是否需要长期保存原始母带(需要则优先多盘位HDD机型)、是否有稳定的国内团队远程协作(有则优先回国线路优化的机房)。踩坑点集中在两处:一是只看标称带宽不看是否独享,二是把训练和转码塞进同一台机器导致互相抢资源。
选购推荐
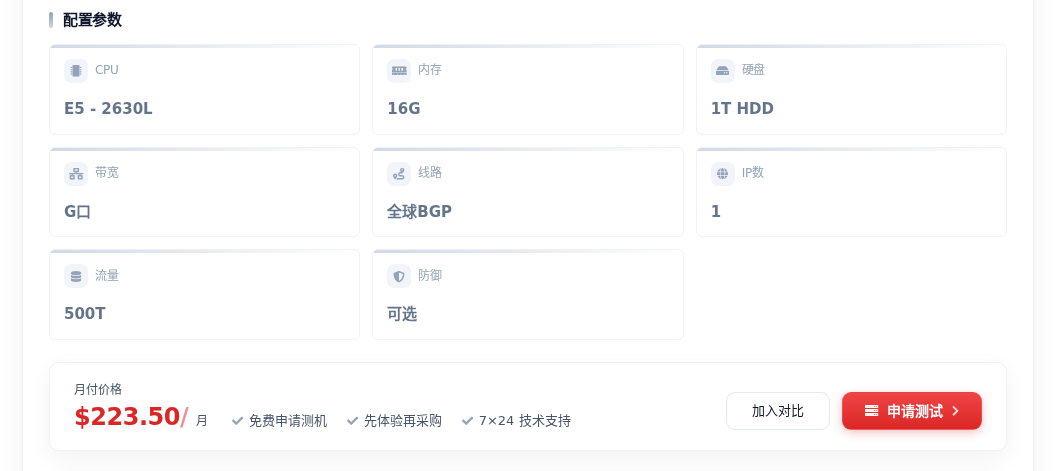
结合上面的成本结构,如果是素材中转、模型缓存加译制流水线这类以吞吐和存储为主的场景,日本大带宽服务器 IV(E5-2630L / 16G / 1T HDD / G口带宽,200T流量,223.5元/月)适合作为试水期的入口机型,G口带宽拉模型和回传素材都不憋屈。如果译制量上来、需要多核并发转码和大容量NVMe做热数据盘,日本原生IP物理服务器 ⑤(Gold 6138×2 / 256G / 1.92TB SSD×4,40M带宽,1278.00元/月)在内存和固态容量上更从容,适合把字幕、配音、超分几条流水线并行跑。两款都走BGP智能路由优化,国内远程操作延迟相对可控,独享资源不超售对批量下载模型这类场景比较关键。
决策建议:先用大带宽机型验证素材吞吐和版权流程,确认业务量级后再按「训练租GPU、译制上物理机」的分层思路扩容。带宽和存储的钱花在明处,版权合规的钱花在事前,比事后补救便宜得多。