日本服务器跑SD出图:模型下载慢、显存爆?这些坑先算清
把Stable Diffusion放到日本服务器上跑,多数团队第一次上手会同时撞上两堵墙:一是下模型慢到怀疑网络,二是跑着跑着显存爆了。日本机房对东北亚访问确实友好,但AI绘画是「带宽吃下载、显存吃推理、硬盘吃模型库」的三重消耗,配置拍脑袋很容易钱花了跑不动。下面按成本账拆开讲。
坑一:模型下载速度——40M带宽下20G模型要等一晚上
SD生态的模型体积不小:基础大模型(SD1.5约4G、SDXL约6.9G、Flux类更大)、常用LoRA几十到几百MB、ControlNet与VAE若干G,一个像样的模型库轻松几十上百G。下载速度直接由服务器带宽决定,按理论值估算:40M带宽约5MB/s,下载20G要1小时以上;100M约12MB/s;G口(1000M)约125MB/s,几分钟搞定。实际还会受源站限速、国际出口拥塞影响,通常打个对折看。
避坑要点:
- 别只看「G口」字样,确认是独享还是共享,独享G口才敢按125MB/s估。
- 模型源优先用国内可达性好的镜像站或提前在本地下好再上传,上传同样吃带宽。
- 首次部署建议选大带宽机型跑完模型拉取,之后可换小带宽机器长期推理,或直接用对象存储挂载。
- 40M带宽机型适合「模型已就位、只做API出图」的场景,不适合频繁换模型的工作流。
坑二:显存怎么配——先算清楚你要跑什么分辨率
显存是SD推理的硬门槛,通用经验量级如下(含常用优化,如半精度、xformers/Flash Attention):
- SD1.5、512×512出图:6~8G显存可跑,8G较稳。
- SDXL、1024×1024:12~16G起步,16G更从容;批量出图或多ControlNet叠加要24G。
- Flux等新模型、高分辨率放大、LoRA多开:24G甚至48G更现实,否则靠CPU offload换速度。
这里有个常见误区:以为买台高配CPU物理机就能跑。SD推理吃的是GPU,纯CPU出图一张要几十秒到几分钟,做批量素材生成基本不可用。所以「日本服务器跑SD」通常指两类方案:GPU云主机/GPU物理机,或CPU机器做调度与前后端、GPU机器专职推理的混合架构。
成本账大致分三块:GPU算力(云GPU按小时计费,长期跑物理机更划算,月成本量级从数千到上万视卡型而定)、CPU与内存(调度、WebUI、批处理队列,16~64G内存量级)、存储与带宽(模型库建议NVMe,百G级起步;带宽按上文估)。中小团队若只是内部出图与素材生产,一张16~24G显存的卡加一台中配CPU机器,是性价比较高的组合。
坑三:日本落地的合规与线路细节
日本机房做AI绘画业务有几个真实差异点:素材与版权合规要留意,训练/微调用的动漫、人像素材在日本与出口目标市场的版权规则不同,商用出图建议保留模型来源与授权记录;面向国内团队协作时,BGP智能路由优化的线路访问更顺畅,普通国际线路晚高峰可能抖动;IP方面,原生IP对部分平台的风控更友好,做素材分发、店铺后台登录时少踩验证码的坑。
选购时建议对比这张清单:带宽独享/共享与口子大小、硬盘是否NVMe及容量、内存量级、IP是否原生、是否支持按需升配、工单响应速度、支付方式是否灵活。这些比单纯比价格更能决定后续会不会返工。
选购推荐
结合上面的账,给两类典型团队各一个方向:
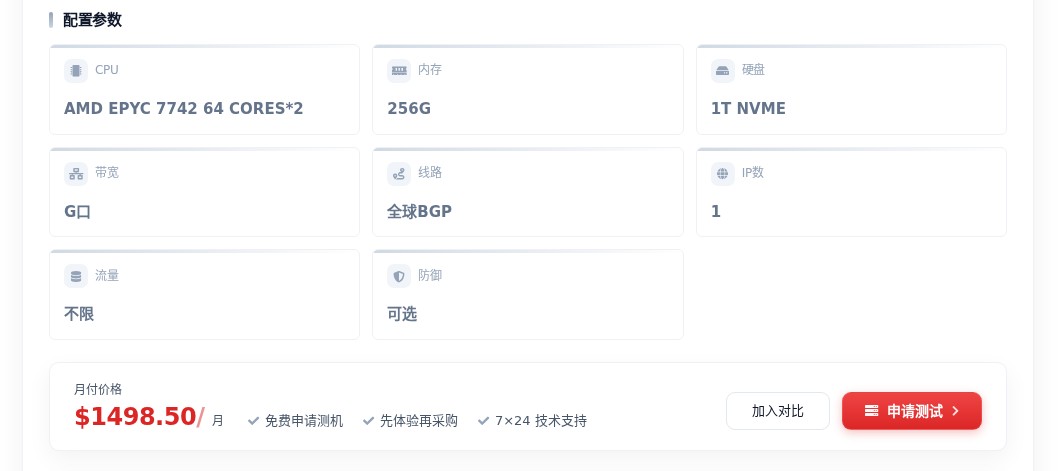
如果模型库大、需要频繁拉取与切换模型,优先看大带宽机型。日本大带宽服务器 XLI(AMD EPYC 7742 64核×2 / 256G / 1T NVMe / G口带宽,1498.5 元/月)适合做模型仓库、批量任务调度与前后端承载,G口拉模型的速度优势在首次部署时最明显,256G内存也够跑多任务队列。
如果预算有限、以API出图和素材生成为主,模型已提前上传,则日本原生IP物理服务器 ②(Intel Xeon Gold 6138×2 / 64G DDR4 / 1.92TB SSD / 40M带宽,486.11 元/月)是更务实的控制成本选择:双路CPU加64G内存足以承载WebUI与任务队列,1.92TB SSD放常用模型够用,原生IP对平台侧操作更稳。注意40M带宽不适合频繁下载大模型,建议模型一次到位。
决策建议:先按「出图分辨率定显存、模型库大小定硬盘、换模型频率定带宽」三步锁定需求,再决定GPU算力放在云上还是物理机;日本机房的价值在于东北亚低延迟与原生IP,别把它当纯下载机用。预算紧就先小带宽+够用显存跑通流程,等出图量稳定再升配,比一步到位买贵机器更不容易踩坑。