在日本服务器上跑Stable Diffusion,批量出图要多大显存与带宽才够
做AI绘画批量出图,最先卡住的往往不是模型,而是机器:本地显卡跑一张1024×1024要几十秒,一次活动要出几百上千张图,机器一热就降频,硬盘还塞满。把Stable Diffusion放到日本服务器上跑,是个人站长和自媒体博主比较现实的解法——既能用上大显存卡,又离东北亚用户近、素材传输快。但「要多大显存」「要多少带宽」「租云GPU还是物理机」这三个问题,答案取决于你的出图量,下面按需求给判断标准。
先算显存:出图分辨率与批大小决定显卡档位
Stable Diffusion的显存占用主要来自模型权重、分辨率与批大小。经验量级:SD 1.5在512×512单张推理,8G显存可以跑;SDXL在1024×1024单张,一般建议12G起步,16G更稳;如果要做批量出图(batch size 4~8)或同时挂LoRA、ControlNet,显存需求会明显上升,24G是比较舒服的档位。常用显卡按性价比大致分三档:
- 入门档(8G~12G):RTX 3060 12G、RTX 4060 Ti 16G这类,适合SD 1.5、小尺寸封面图、每天几十到一两百张的量。
- 主力档(16G~24G):RTX 4080、RTX 4090、L20等,SDXL 1024出图、批量4张、带LoRA与放大流程,适合日更自媒体与电商主图批量生成。
- 多任务档(24G以上 / 多卡):A100、H100、L40S等,适合同时跑多个工作流、数字人素材或短剧分镜批量出图,成本高,一般按小时租更划算。
判断标准很简单:先确定主力分辨率和是否用SDXL,再决定显存下限;如果单次出图经常OOM,优先加显存而不是加CPU。CPU与内存方面,16核以上、64G内存是比较稳的配置,模型加载与图片后处理都吃内存。
再算带宽:出图是算力活,交付才是带宽活
很多人误以为跑SD要很大带宽,其实推理过程几乎不耗公网带宽,真正吃流量的是「模型下载」和「图片回传」。一个SDXL基础模型约6~7G,加上LoRA、VAE、放大模型,首次部署往往要拉几十G。按40M带宽估算,下载30G素材大约需要1.5~2小时;如果用G口带宽,十几分钟就能完成。日常出图后回传到对象存储或直接给客户预览,单张图几MB,一天几百张也就几个G,40M带宽足够;但如果是短剧分镜、电商详情页这类成批交付,或者要对外提供在线出图页面,建议选100M以上或G口。
判断标准:日交付图片总量×单张大小÷峰值时段秒数,估算出需要的稳定带宽,再留一倍余量。硬盘建议NVMe起步,模型与输出图分盘存放,避免IO拖慢加载。
日本机房的真实差异:线路、合规与访问速度
选日本服务器跑SD,有几个本地化细节不能忽略。线路方面,面向中文用户做内容站或出图后台,优先选带BGP智能路由优化的机房,国内访问延迟通常比普通国际带宽稳定;如果主要服务日本本地与东北亚用户,日本本土BGP线路本身就够用。合规方面,日本对AI训练素材与生成内容的版权讨论较活跃,商用出图要避开明显侵权的画风与素材,客户交付前留存生成记录更稳妥。另外,日本机房对游戏、动漫相关业务接受度高,做二次元风格出图、周边素材批量生成,落地在日本是比较自然的选择。
避坑要点:一是别只看「GPU型号」不看整机,共享GPU超售会导致出图排队;二是确认是否独享资源、能否自行安装CUDA与WebUI;三是问清流量是否不限或超额计费,批量交付很容易踩流量坑。
选购推荐:按出图量对号入座
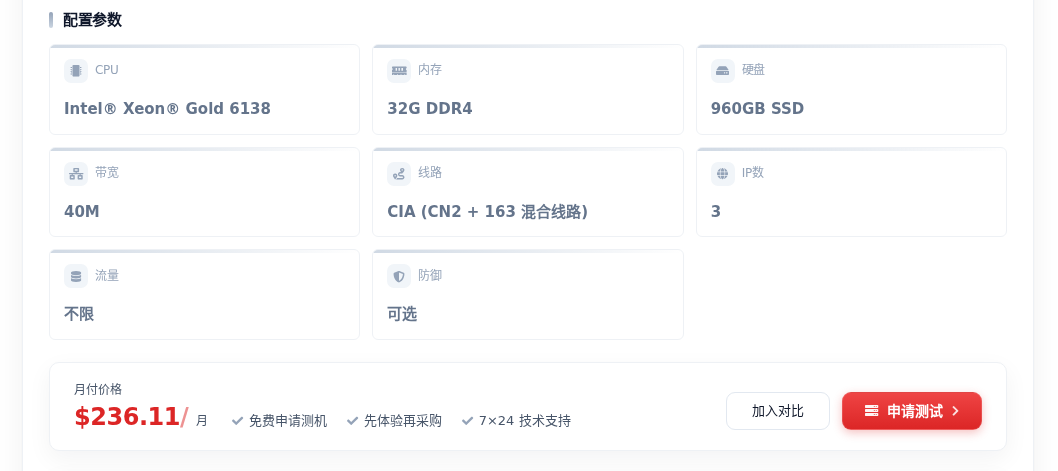
如果是个人站长或自媒体博主,日常以SD 1.5和少量SDXL出图为主,模型与素材规模不大,可以先从带原生IP的物理服务器起步,把预算留给后续升级显卡:日本原生IP物理服务器 ①,Intel Xeon Gold 6138 / 32G DDR4 / 960GB SSD / 40M带宽,236.11 元/月,适合做推理调度、素材管理与轻量出图后台,40M带宽应对日常图片回传够用。
如果是要批量出SDXL、同时挂多个工作流,或者对外提供出图服务,带宽和存储会成为瓶颈,这时更适合大带宽整机:日本大带宽服务器 XL,AMD EPYC 7742 64核×2 / 256G / 1T NVME / G口带宽,1483.5 元/月,G口拉模型和批量回传都痛快,256G内存也撑得住多任务并行。秀米云日本机房主打中文用户网络优化与独享资源不超售,对需要稳定出图队列的用户比较友好。
决策建议:先按「主力分辨率定显存、日交付量定带宽」两条线算出下限,再决定租云GPU还是物理机。出图量不稳定、只是偶尔批量生成,按小时租GPU更省;要长期日更、模型和素材越攒越多,直接上日本物理服务器更可控。别一上来追顶配,先把工作流跑通,再按瓶颈加显卡或加带宽。