东京机房跑动漫素材AI训练要花多少钱?个人站长的成本账与选型步骤
手里攒了几万张动漫分镜、立绘和短剧切片,想用 LoRA 或开源扩散模型微调一套自己的画风,第一步就会卡在「机器放哪」。放国内机房,素材上传和成品下载都慢;放欧美,东北亚的粉丝打开预览页要转圈。东京机房是折中解,但它不是免费的午餐——算力、存储、带宽、合规,四笔账要分开算。
一、先把四笔账拆开:训练一次到底花在哪
动漫素材训练不是「买张显卡就完事」,成本分四块:
- 算力账:微调一个 2B~7B 量级的图像模型,单卡 24G 显存通常能跑 LoRA;全量微调或训练视频/短剧译制模型,一般要 48G 以上显存或双卡。云 GPU 按小时计费,长期跑下来月账单常见在数百到数千元量级;物理机则是固定月租,跑得越久越划算。
- 存储账:动漫素材单张不算大,但几万张加上中间 checkpoint,通常要 1T~2T NVMe。机械盘便宜但读图慢,训练集建议放 NVMe。
- 带宽账:素材上传、成品分发、粉丝预览页访问都吃带宽。100M 独享和 G 口是两个体验层级,价格差通常在数倍。
- 合规账:这是最容易被忽略的一笔,见下一节。
二、版权合规:东京机房不是「法外之地」
很多人以为放到日本就绕开了素材版权问题,这是个坑。日本著作权法对 AI 学习阶段有一定弹性,但对输出结果的商用、角色形象相似性审查并不宽松;平台侧(YouTube、TikTok、Pixiv)的投诉机制更直接。实操上要做三件事:
- 训练集留档来源,区分「自有素材」「授权素材」「公开数据集」,别混在一个目录里。
- 成品发布前做相似度自查,尤其是知名角色二创,商用前建议咨询专业意见。
- 服务器上不要存放无授权的整部作品源文件,训练完的中间集及时清理,降低被投诉时的举证成本。
合规做在前面,比事后删库便宜得多。
三、东北亚访问速度:怎么判断一台东京机器够不够快
东京机房对国内和日韩用户的延迟优势是真实的,但「东京」两个字不代表线路一定好。选购时按这份清单对比:
- 线路类型:是否 BGP 智能路由、回国方向是否优化,直接决定国内访问是 60ms 还是 200ms。
- 带宽是否独享:超售机在晚高峰会掉速,训练任务的上传下载都会被拖累。
- 硬盘类型:NVMe 与 HDD 在加载几万张小图时差距明显。
- IP 属性:原生 IP 对部分平台的风控更友好,做短剧分发、独立站预览页时值得确认。
- 工单响应:训练跑通宵,出问题时响应速度就是成本。
判断标准很简单:让服务商提供测试 IP,自己在晚八点 ping 一轮、下一轮素材包,比看任何宣传页都准。
四、手把手部署步骤:从零到跑通一次微调
- 估配置:先按「显存 ≥ 24G、内存 ≥ 64G、NVMe ≥ 1T」起步;要跑视频类译制模型,内存往 128G~256G 走。
- 选机型:短期试验用云 GPU 按小时跑;确定长期做内容,直接上物理机摊薄月成本。
- 装环境:系统盘装驱动与推理框架,数据盘单独挂载放素材,避免 checkpoint 撑爆系统盘。
- 小样本验证:先用 500 张图跑一轮,确认显存占用和单轮耗时,再放大到全量。
- 分发链路:成品放同机 Web 目录或对象存储,国内粉丝走优化线路预览,日韩用户直连。
- 备份与清理:训练集定期归档,中间文件按周清理,控制存储账单。
避坑要点:不要一上来买 G 口带宽跑单机训练,带宽只在分发阶段才值钱;也不要拿 HDD 机型当训练盘,读图瓶颈会让 GPU 空转。
选购推荐
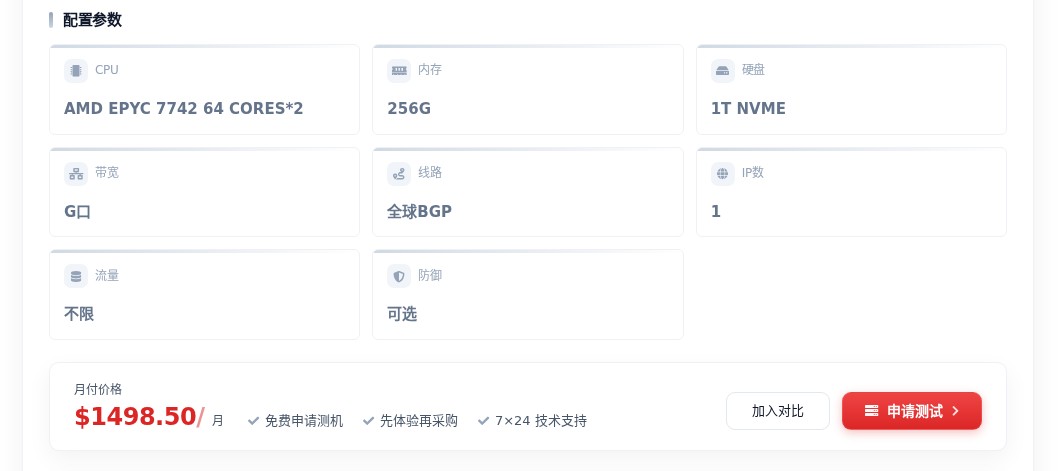
按上面的账算下来,长期做动漫素材训练与短剧分发的个人站长,更适合「大内存 + NVMe + 优化线路」的物理机,而不是按小时烧云 GPU。秀米云日本大带宽服务器 XLI 是这一档里比较均衡的选择:AMD EPYC 7742 双路、256G 内存、1T NVME 加 G 口带宽,1498.5 元/月,训练跑得动,成品分发也扛得住东北亚的访问量,适合已经确定要长期产出内容的博主。如果预算更紧、以图文素材为主,日本原生IP物理服务器 ⑤ 更务实:Gold 6138 双路、256G DDR4、四块 1.92TB SSD、40M 带宽,1278.00 元/月,原生 IP 对平台风控友好,存储空间足够囤几万张素材,具体可看 日本大带宽服务器 XLI 与 日本原生IP物理服务器 ⑤ 的配置页,按自己的素材体量和分发需求二选一即可。
决策建议:先用云 GPU 小样本验证模型跑得通,再按「显存定档、NVMe 定盘、带宽定分发」三步锁机型;合规留档和线路测试要在付款前做完,这两件事省下来的钱,比砍配置多得多。