Llama私有化部署在日本:游戏服主租GPU还是买物理机三年账怎么算
游戏私服或联机服主最近常被两件事夹击:一是玩家群里开始用Llama 3做自动化客服、工单分流甚至反作弊语义分析,二是日区云GPU报价单越看越像“租得起、跑不起”。到底在日本机房跑Llama私有化,是租GPU划算,还是买物理机三年账更漂亮?先把场景钉死:服主通常要的是7×24常驻推理,模型量级在Llama 3 8B到70B之间,并发不高但延迟要稳,同时还要兼顾游戏联机服的CN2/BGP回程质量。
热点解读:Llama 3.1开源后,选型发生了什么变化
Llama 3.1把8B、70B、405B统一开源,直接改变了中小团队的部署逻辑。过去8B模型用单卡24G显存(如RTX 4090/3090)就能跑FP16,现在社区更推荐量化到INT8或GPTQ,8B可压到10G以内,70B则需要4×24G或2×48G起步。对游戏服主而言,这意味着“租一张卡试水”的门槛降低了,但长期跑70B的显存成本依然是大头。日本机房的差异在于:东京、大阪节点到国内东北亚玩家延迟低,且本地对AI训练素材的版权合规审查较严,私服若用玩家聊天记录做RAG知识库,需注意数据落地位置与脱敏,别把用户对话原样喂进模型。
方案横评:租GPU、买物理机、混合架构三年账
先给判断标准:把“三年总拥有成本÷月均推理请求量”作为核心指标,再叠加显存、带宽、运维人力三项隐性成本。
- 租GPU(云显卡):日区单卡24G月租通常在数千元量级,48G/80G更高,按需计费灵活但常驻成本高。适合模型未定型、并发波动大的阶段。坑在于:部分服务商GPU实例共享带宽,推理高峰期排队;且数据出机房需额外评估合规。
- 买物理机(自建推理):一次性投入GPU卡与整机,三年折旧后单月成本可压到云租的30%~50%。但需要自己处理驱动、CUDA版本、模型热更新与故障切换。游戏服主若已有运维习惯,这条路更稳;若没有,运维人力会吃掉省下的钱。
- 混合架构:物理机跑常驻8B客服模型,云GPU按需跑70B批量任务(如赛季更新时的日志分析)。三年账最平衡,但架构复杂度上升,适合有1~2名兼职运维的团队。
带宽估算别忽略:Llama推理的token流对带宽要求不高,但RAG知识库同步、模型权重下载(70B约140G)会吃满入口带宽,日本机房建议至少20M起步,G口更适合多服主共用。
实操避坑:日本机房跑Llama要对比的参数清单
选购时逐项打勾:显存容量与卡型(24G/48G/80G)、是否独享GPU而非vGPU切片、机房到国内东北亚的回程线路(CN2 GIA或BGP优化)、是否支持原生IP(游戏登录与支付风控需要)、电力与散热冗余、工单响应时效、数据落地与日志留存政策。常见坑:标称“GPU服务器”实为共享算力;日本原生IP被滥用导致风控;模型权重下载限速;以及忽略Llama 3.1社区许可证对商用规模的限制条款。
选购推荐
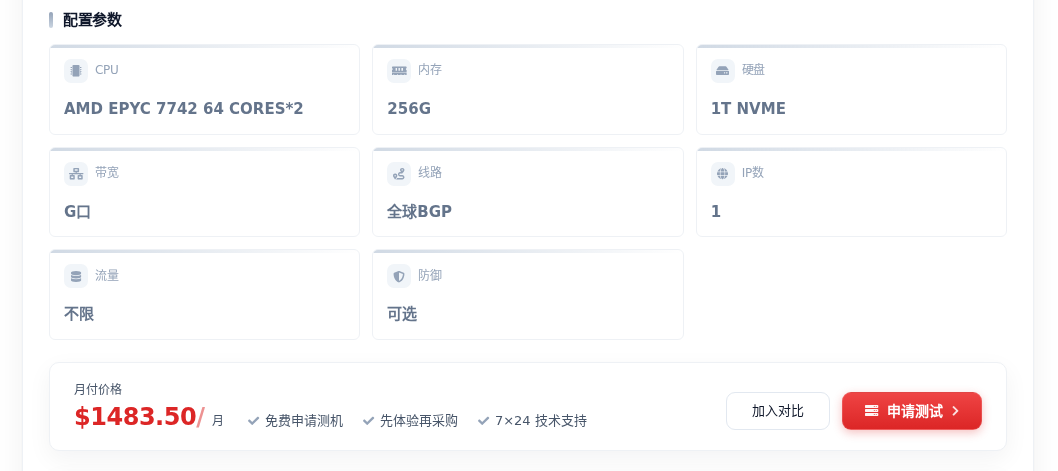
对多数游戏服主,起步阶段建议先用物理机承载8B常驻推理与游戏联机服务,把GPU预算留给验证期。秀米云日本原生IP物理服务器④(Intel Xeon Gold 6138×2 / 64G DDR4 / 16TB HDD×3 / 40M带宽,1056.00 元/月)适合做RAG知识库与客服模型常驻节点,原生IP对游戏登录与支付风控友好,大存储便于留存日志与模型权重。若后续要跑70B或多服主共用,可考虑日本大带宽服务器 XL(AMD EPYC 7742 64核×2 / 256G / 1T NVME / G口带宽,1483.5 元/月),G口带宽能扛住权重同步与多实例推理,独享资源不超售,适合把三年账压在自建路线的团队。
决策建议:模型未定型、并发波动大,先租GPU验证;确定常驻8B客服且已有运维习惯,买物理机三年账更优;70B以上或多人共用,混合架构加G口物理机是折中点。别忽略回程线路与原生IP,这两项在日本机房直接决定玩家体验与风控通过率。