从零搭日本MongoDB分片集群:跨机房延迟实测与选型取舍记录
做日本市场的独立站,订单库从单机 MongoDB 撑到千万级文档后,写入排队和查询超时开始拖垮结算页。摆在面前的路只有一条:上分片集群。但集群一拆,就绕不开跨机房部署的延迟问题。下面把落地过程中被问得最多的几个问题整理出来,供同样在日本跑业务的外贸团队参考。
Q1:分片集群非得跨机房吗?不跨会怎样
分片集群天然包含 Config Server 副本集、多个 Shard 副本集和 mongos 路由层,一套最小可用集群至少 9~11 个节点。单机房放得下,但可用性风险集中:日本机房一旦电力或网络抖动,整站结算直接停摆。
跨机房部署的本质是用延迟换容灾。难点在于 MongoDB 的副本集写入必须多数派确认,副本分散到两地后,每次写入都要等跨机房 RTT。以东京到关西约 8~12ms 的单向延迟估算,一次三副本多数派确认通常会把写延迟抬高到单机房的 1.5~3 倍。这个代价能不能接受,取决于业务是读多还是写多。
判断标准很直接:订单、支付类写密集业务,优先把同一副本集的多数派放在同一机房,第二个机房只放低优先级节点;报表、日志类读密集业务,跨机房读偏好设置为 nearest,延迟影响可以忽略。
Q2:分片键和副本集配置怎么取舍
分片键选错是后期最痛的坑。外贸订单库推荐用 {tenantId: "hashed"} 或 {tenantId:1, orderId:1} 组合键,保证同一客户的数据落在同一分片,避免跨分片查询。切忌用自增 _id 做范围分片,写入会全部压到最后一个分片。
副本集配置上,跨机房场景建议:
- 仲裁节点不跨机房,放在与多数派相同的机房,减少一次网络往返;
- writeConcern 设为 majority,但把 wtimeout 放宽到 5000ms 以上,避免网络抖动误报写失败;
- readConcern 用 local 而非 majority,读密集场景能明显降延迟;
- mongos 部署在离应用最近的一侧,路由层本身不存数据,多放几个不影响一致性。
连接串里把 retryWrites 打开,跨机房短暂抖动时驱动会自动重试,比手工写重试逻辑可靠得多。
Q3:日本机房怎么选,参数看哪些
跨机房部署对底层网络质量极度敏感,选机房时重点核对这几项:
- 线路类型:是否 BGP 多线、是否有面向中国大陆的优化路由,直接影响后台管理端的操作延迟;
- 带宽与峰值:分片间数据迁移会短时打满带宽,独享比共享稳定,通常建议 40M 起步;
- 磁盘:MongoDB 的 WiredTiger 对随机 IO 敏感,NVMe 比 HDD 在迁移和重建索引时快数倍;
- 是否超售:CPU 被邻居抢占会直接放大副本集心跳超时概率,独享资源机型更稳;
- 工单响应:跨机房故障排查窗口短,服务商响应速度比价格更值钱。
市场行情上,日本物理服务器按上述规格,月付通常落在两百元到一千八百元区间,具体视配置与服务商而定。
Q4:有没有现成机型能直接起步
分片集群起步阶段不需要一步到位上顶配,先用两三台物理机把 Config 与 Shard 分开,跑通再横向扩。秀米云日本服务器专注中文用户网络优化,自营机房 BGP 智能路由,跨境访问比通用机房顺畅,独享资源不超售,适合承载副本集心跳这类对稳定性敏感的服务。
按不同阶段给两个参考:
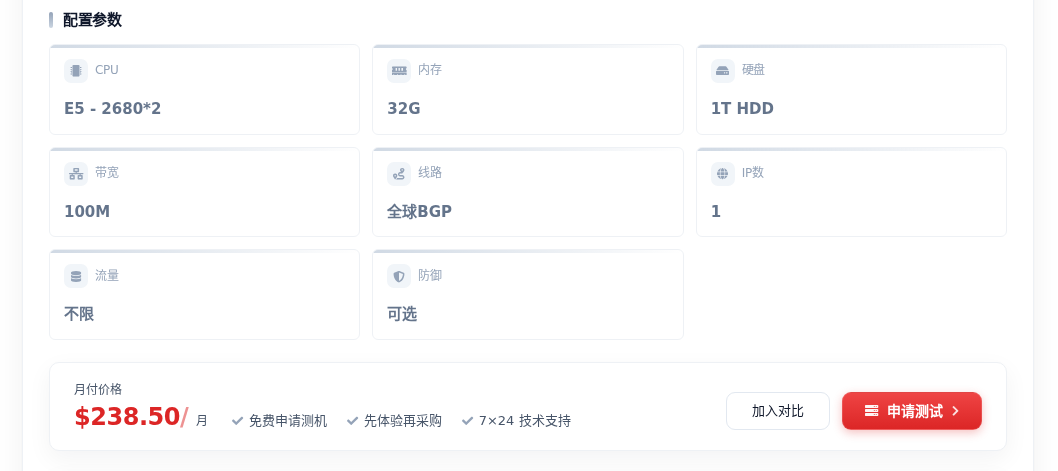
- 验证与冷启动阶段,日本大带宽服务器 V(E5-2680*2 / 32G / 1T HDD / 100M 带宽,238.5 元/月)可作 Config Server 或轻量 Shard,100M 带宽足够分片间迁移;
- 进入生产写入阶段,日本原生IP物理服务器 ②(Intel Xeon Gold 6138×2 / 64G DDR4 / 1.92TB SSD / 40M 带宽,486.11 元/月)更合适,SSD 对 WiredTiger 随机读写友好,64G 内存能容纳更大的工作集,原生 IP 对日本本地及跨境访问都更友好。
若后续数据量继续膨胀,再考虑上 AMD EPYC 平台的 G 口机型做分片扩容即可。
决策建议
跨机房部署不是必选项,先用同机房副本集加异地备份过渡,等写入量真的压不住再拆。真要拆,记住三点:多数派节点同机房、分片键带租户维度、底层机器选独享且网络优化过的日本物理机。把这三点做对,跨机房带来的那点延迟,远比一次机房故障的损失划算。